大模型技术迭代驶入深水区,Agentic AI加速从技术概念走向产业落地,万亿级Token服务正在成为千行百业智能化转型的刚需。但产业快速扩张的背后,盲目堆叠GPU带来的算力空转、通信阻塞、运维复杂等问题日益凸显,“规模越大、成本越高”的困境,成为制约AI规模化商用的现实阻碍。
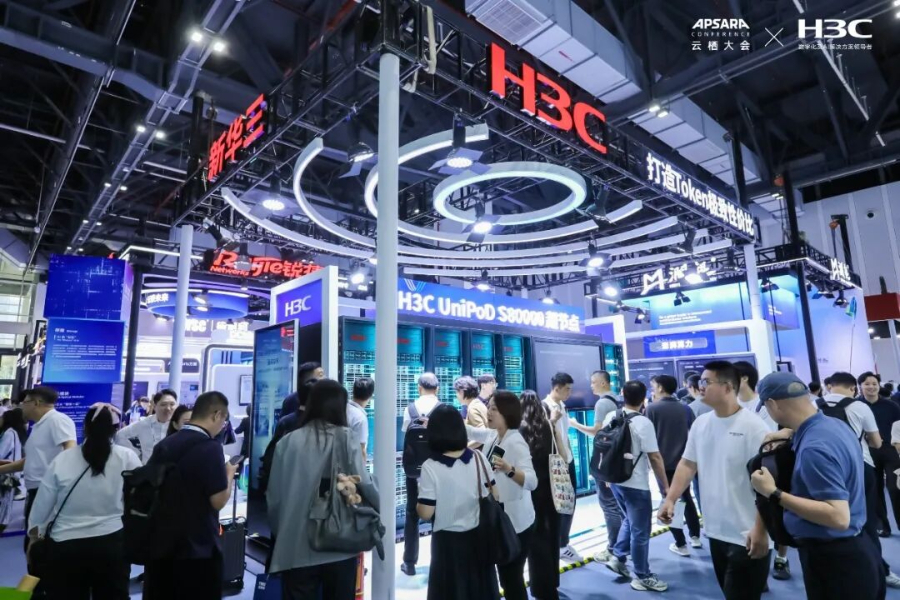
9月22日至24日,2026云栖大会在杭州国际博览中心举办。紫光股份旗下新华三集团以“打造Token极致性价比”为核心主线,集中展示算、网、存三大维度下一代智算基础设施成果,联合产业链各界探索降本增效的可行路径,为大模型训练推理、智能体规模化运行夯实底层技术根基。
算网存一体化协同,筑牢Token高效生产技术底座
过去一段时间,智算建设一度陷入“以硬件规模论强弱”的思维定式。随着万亿参数大模型不断涌现,单纯依靠硬件数量扩容的建设模式,边际效益持续递减。产业界逐渐形成共识:AI算力比拼,早已不是单卡、单机的性能竞赛,而是算、网、存多环节联动的系统能力较量。
立足这一产业现实,新华三本次参展跳出单点硬件迭代的传统思路,围绕Token生成、传输、存储的完整业务链路,集中展出超节点算力底座、全场景智算网络、AI原生存储等一系列新品,依靠算-网-存深度协同破解集群效能瓶颈。
作为本次展会的核心成果,UniPoD S80000超节点面向万亿参数模型训推一体场景打造。该产品支持32卡至1024卡灵活部署,可弹性扩展至16384卡规模,兼容CPU、GPU、NPU、DPU等多类型异构算力,实现“一云纳百算”的算力纳管能力。区别于简单的硬件堆叠,这套超节点从算力组织、数据供给、互联通信、资源调度到运维管理开展系统性优化,打通从底层芯片到上层AI应用的效率链路。在新华三特定模型负载测试环境下,平台实现训练性能提升70%、推理性能提升3倍,把硬件规模转化为实实在在的Token产出效能。
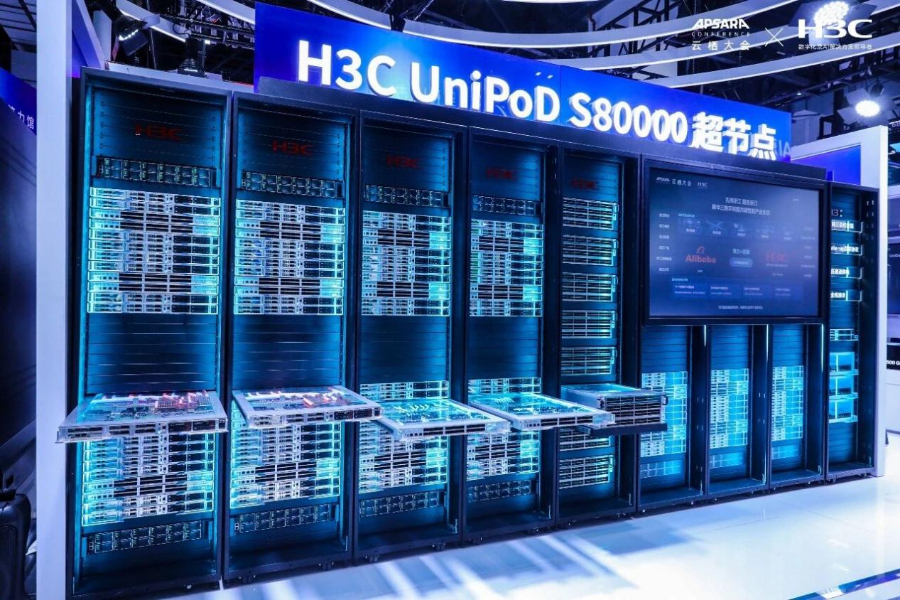
AI业务场景千差万别,超大规模训练、中小规模微调、高并发推理对算力形态提出截然不同的要求。为此,新华三搭建起覆盖标卡服务器、模组服务器、高密液冷整机柜的完整算力矩阵。H3C UniServer R5500 G7 X面向超大规模AI训练场景,适配千亿至万亿参数大模型研发与微调,遵循OCP OAI 2.0开放硬件标准,保障算力架构可持续迭代。H3C UniServer R53X0 G7 Ultra作为训推一体异构算力引擎,兼顾小规模模型训练与高并发业务推理,能够承载智能体调度运行任务,适配智算中心、边缘AI、企业自建AI平台等多元场景。依托磐宁NingOS操作系统与UniSystem智能中枢,算力资源可以根据业务任务动态调配,进一步拉高资源整体利用水平。
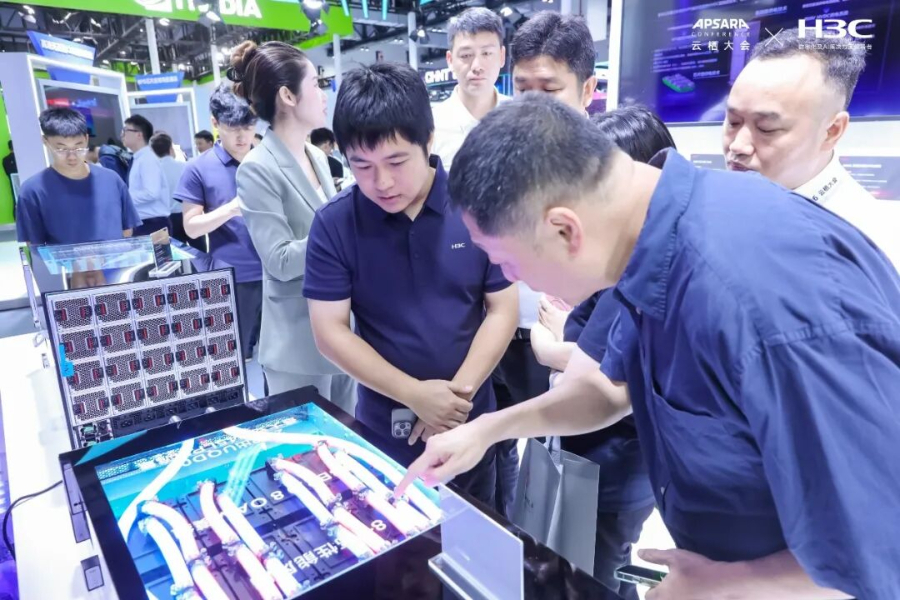
网络,是大规模智算集群的“血管”,直接决定算力能否充分释放。本次大会上,新华三展区完整呈现覆盖Scale-Up节点内互联、Scale-Out节点间互联、Scale-Across跨数据中心互联的智算网络产品矩阵。在节点内部,S9828-128EO单芯片102.4T NPO硅光智算交换机采用光电合封技术,测试环境下端到端时延降低15%,搭配光链路智能诊断、关键组件可替换设计,有效降低高密度集群运维压力。面向集群横向扩展,S9828-64FP高密1.6T智算交换机搭载224G SerDes超高速通道,通过VPD垂直供电、风液协同散热等优化,高密部署场景测试下能耗降低20%以上。针对同城多数据中心协同难题,S12500R-64EP 800G智算DCI交换机依托SRv6协议与自研拥塞控制算法,该方案可实现跨100公里级的无损传输与梯度同步,打破地理边界带来的算力孤岛。
存储环节直接影响着AI数据供给效率。推理场景下海量KV Cache数据爆发式增长,正在把存储推到智算性能博弈的前沿。新华三展台带来UniStor X20000系列旗舰产品X20836 AI原生存储,单节点能够提供200GB/s带宽、300万IOPS。全速引擎测试条件下可降低30%GPU等待时长;平台同时支持块、文件、对象、HDFS四协议互通,大幅压缩模型训练前期的数据准备周期;32+2高比例纠删码技术,将存储可用容量提升至94%。针对推理业务痛点,XCache推理加速引擎实现KV Cache多级缓存卸载,测试环境下首Token时延降低90%,同等算力条件下用户并发数提升10倍。此前,UniStor X20000系列已经登顶MLPerf Storage v2.0 RoCE AI存储解决方案榜首,为全链路Token生产构建坚实的数据底座。
凝聚产业链共识,共探Token性价比系统攻坚路径
技术底座的突破,离不开产业生态的协同共进。9月23日,新华三举办“打造Token极致性价比——下一代智算关键技术创新论坛”。阿里云、平头哥、英特尔、博通、清程极智、是石科技等企业技术专家齐聚现场,从产业现状、底层架构、网络演进、存储瓶颈、软件落地多个维度展开研讨。与会嘉宾形成共识,Token极致性价比并非依靠某一款硬件、某一项算法就能一蹴而就,它是贯穿芯片、算力、网络、存储、调度软件的系统工程,需要产业链各方破除壁垒、协同攻坚,削减全链路资源损耗。
新华三集团高级副总裁、网络产品线总裁乔剡在致辞中指出,当前智算产业遇到的诸多瓶颈,已经很难依靠单一硬件迭代实现突破。只有坚持系统级创新,推动全栈技术协同,联动上下游产业伙伴携手共建生态,才能夯实人工智能产业长期健康发展的根基。阿里云专有云网络和安全负责人、资深技术专家张然则立足云产业实践,分享智算中心建设与成本管控的现实思考,呼吁产业各方强化协同,扫除技术落地障碍,推动大模型业务走向大规模商用。
论坛上,业内专家逐层拆解实现Token极致性价比的技术路径。算力架构层面,新华三先进技术研究部总经理朱仕银表示,超节点不是服务器与加速卡的简单堆砌,而是高速互联、供电散热、软件栈深度耦合的系统工程。在跟进国内外主流标准协议的同时,持续投入G‑Link高速互连架构的技术创新工作,面向更大规模GPU集群优化带宽、时延与可靠性;同时在高密供电、液冷散热、训推软件栈持续深耕,打造高带宽、低时延、高可靠的超节点算力底座。英特尔数据中心集团首席软件工程师谢义围绕CPU+GPU异构协同给出实践方案,针对智能体时代MoE热点漂移、KV Cache跨轮累积等现实难题,通过异构负载均衡、专用硬件加速等手段,让GPU聚焦核心计算任务,释放整机系统潜能。
随着集群规模持续扩张,智算网络架构如何演进,成为本次论坛热议焦点。阿里云网络研发高级技术专家李旅提出,Agentic AI时代,行业评价AI基础设施的标尺正在发生转变,从单纯看训练算力,转向“每Token成本×SLO服务质量”综合指标,KV Cache已经成为需要网络化承载的核心热数据,开放统一以太网是推理网络演进的产业共识底座。平头哥半导体产品总监李旭慧分享“Switch进网卡”创新思路,通过将交换能力下沉至智能网卡,实现节点内部计算、存储资源高效直连,为超节点内部互联开辟新路径。博通高级产品经理刘婷婷梳理开放以太网的发展路线,以太网凭借标准化与成熟生态,能够覆盖Scale-Up、Scale-Out、Scale-Across全场景,支撑智算集群从万卡向几十万卡规模平滑演进。新华三集团网络产品线智算网络架构师蒋新红介绍跨域协同组网方案,依托高速光互连底座,叠加确定性流量调度、近源拥塞控制、端到端安全加密与故障无缝切换,把地理分散的算力资源聚合为统一资源池,保障分布式训推业务跨区域稳定运行。
推理环节内存资源紧张、KV Cache成本高企,是当前产业面临的突出痛点。新华三集团存储产品线首席架构师陈钊分析,智能体大规模应用之后,大量临时缓存数据挤占内存资源,传统存储架构难以适配高并发推理业务。对此,新华三推出KV Cache整体解决方案,依托多层级差异化存储加速架构,实现KV Cache高效访问与灵活共享,方案向上兼容多种推理引擎与异构算力平台,推动存储从成本负担转变为提升推理效率的重要杠杆。
硬件底座的效能,最终需要通过软件体系承接,方能转化为业务生产力。论坛聚焦国产算力软件适配与智能体长周期训练框架两大落地痛点,探寻从硬件性能到业务价值的转化路径。清程极智联合创始人师天麾谈到,当前国产算力硬件能力快速提升,但软件配套仍存在短板,行业需要补齐推理引擎、评测与智能调度平台等软件能力,推动国产算力从“可用”迈向“好用”。是石科技首席科学家李俊涛剖析智能体长轨迹训练的现实挑战,围绕模型框架适配、长上下文处理、训练过程稳定性等问题,介绍统一强化学习训练框架、异步强化学习架构等探索方向,持续完善智能体工程化训练基础设施。
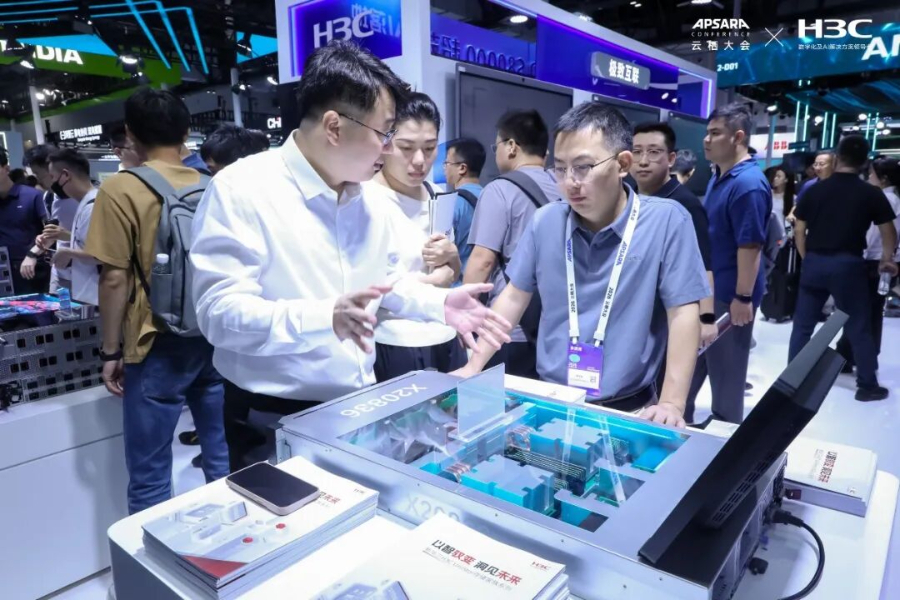
无论是展区展出的系列软硬件产品,还是论坛上碰撞出的产业观点,新华三传递出清晰产业判断,面向Agentic AI时代,算力竞争下半场,核心不再是硬件规模堆砌,而是全链路效能兑现。万亿级Token的规模化服务,需要算力、网络、存储深度协同,同时联动芯片厂商、云厂商、软件服务商共同完善产业生态,打通技术创新到业务落地的“最后一公里”。
面向未来,新华三集团将持续深耕下一代智算关键技术,与产业链伙伴一道,以系统级创新回应AI时代的产业命题,让算力真正成为百行百业智能化升级的坚实底座,赋能AI产业高质量发展。
